Quem escreve não aprova
Terceiro post da série sobre o Olha o Bichim!. Como uma especificação aprovada vira código com TDD, subagentes que não se conhecem e uma revisão que não confia no que o implementador diz.
 Giuliano Cardoso · · 6 min de leitura
Este é o terceiro de cinco posts da série sobre os bastidores do Olha o Bichim!. No anterior, eu falei de como a ideia vira especificação. Agora, como a especificação vira código.
Uma IA programando tem um defeito parecido com o de um estagiário ansioso: ela diz que terminou. "10 de 10 testes passando", "implementado conforme o pedido", e às vezes não está, ou está pela metade, ou fez outra coisa. Então, todo o processo de execução do jogo foi montado em cima de uma premissa simples: quem escreve nunca é quem aprova.
Do plano ao commit
Depois da especificação aprovada, vem o plano de implementação, escrito com a skill writing-plans. Ele é escrito para um engenheiro capaz, mas sem nenhum contexto do projeto, então cada passo traz o arquivo exato, as assinaturas e asserções dos testes, o comando que deve ser rodado e o resultado esperado.
O plano da Asa Branca, o nível 14 do jogo, por exemplo, aponta a especificação ("leia antes de começar") e cada tarefa traz o teste que deve falhar e a mensagem esperada: Esperado: FAIL — Expected: <14> Actual: <13>. Um detalhe curioso é que, nas versões antigas do Superpowers, o plano trazia o código completo; desde a 6.4.2, ele registra decisões em vez de transcrever código, porque os modelos mais novos tentavam implementar o projeto inteiro dentro do plano. Os planos passaram a sair em um quarto do tempo e com cerca de um terço dos tokens, com o mesmo resultado.
TDD: o teste vem primeiro
Toda tarefa segue o ciclo do TDD (a skill test-driven-development): escreva um teste que falha, escreva o mínimo de código pra ele passar e só então melhore o código com o teste protegendo.
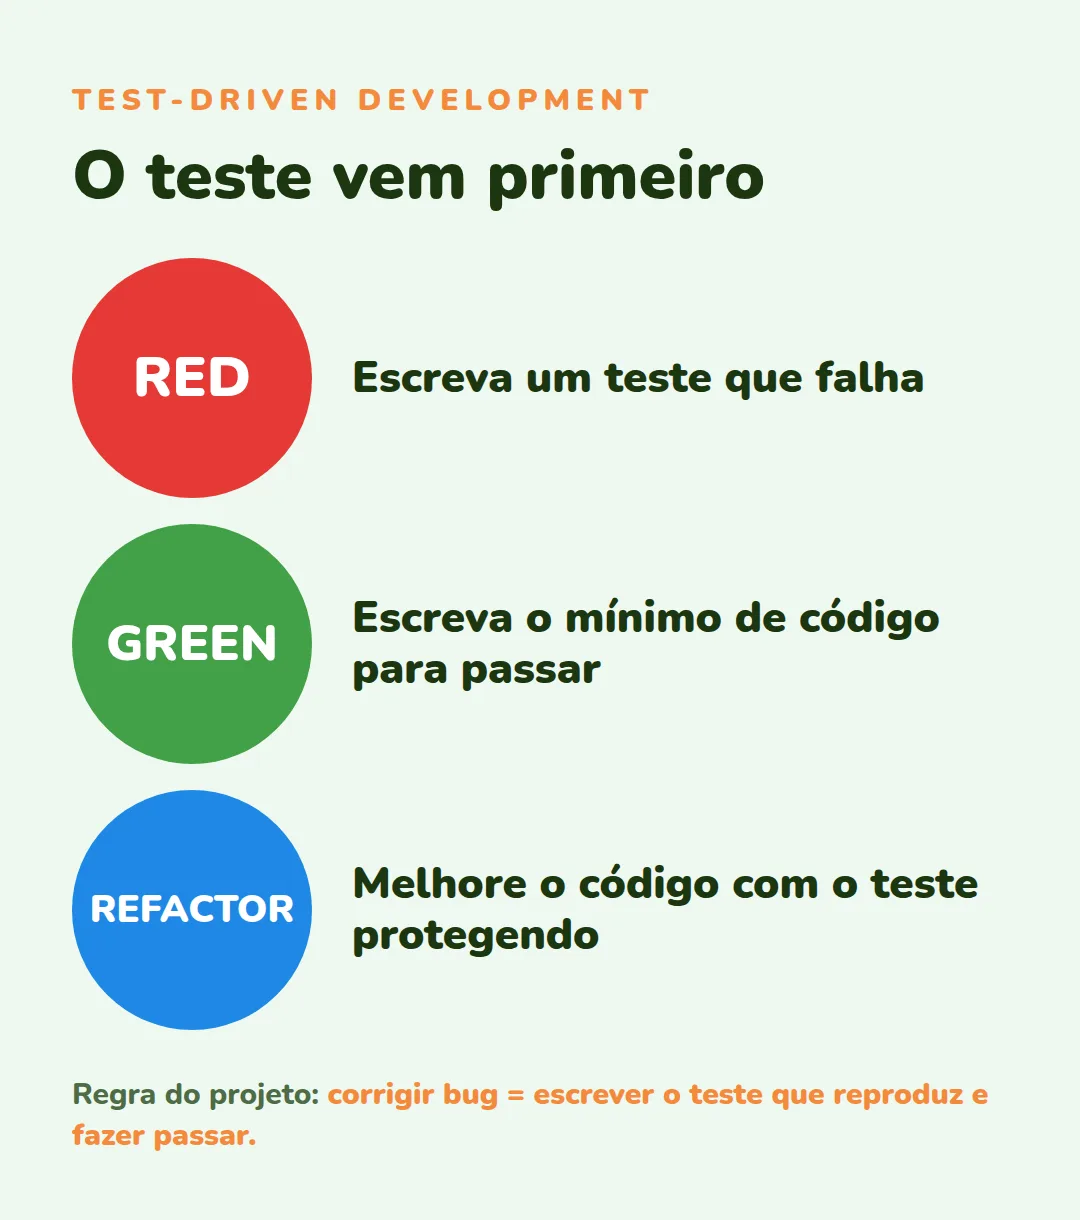
No jogo, isso é regra escrita. O motor do jogo, a lógica pura do 2048, fica em Dart puro, sem Flutter, sem Firebase, sem nada de entrada e saída, e toda mudança nele é TDD, sem exceção. E "corrigir bug" significa "escrever o teste que reproduz o bug e fazer ele passar". Por isso aquela proporção de quase uma linha de teste pra cada linha de código que eu citei no primeiro post: a suíte cresce junto com os bugs.
Uma tarefa, agentes que não se conhecem
A execução usa o Subagent-Driven Development, outra skill do Superpowers. Existe um coordenador, que lê o plano e a especificação, e cada tarefa vai pra um subagente novo, com contexto limpo, que recebe só o texto exato da tarefa.
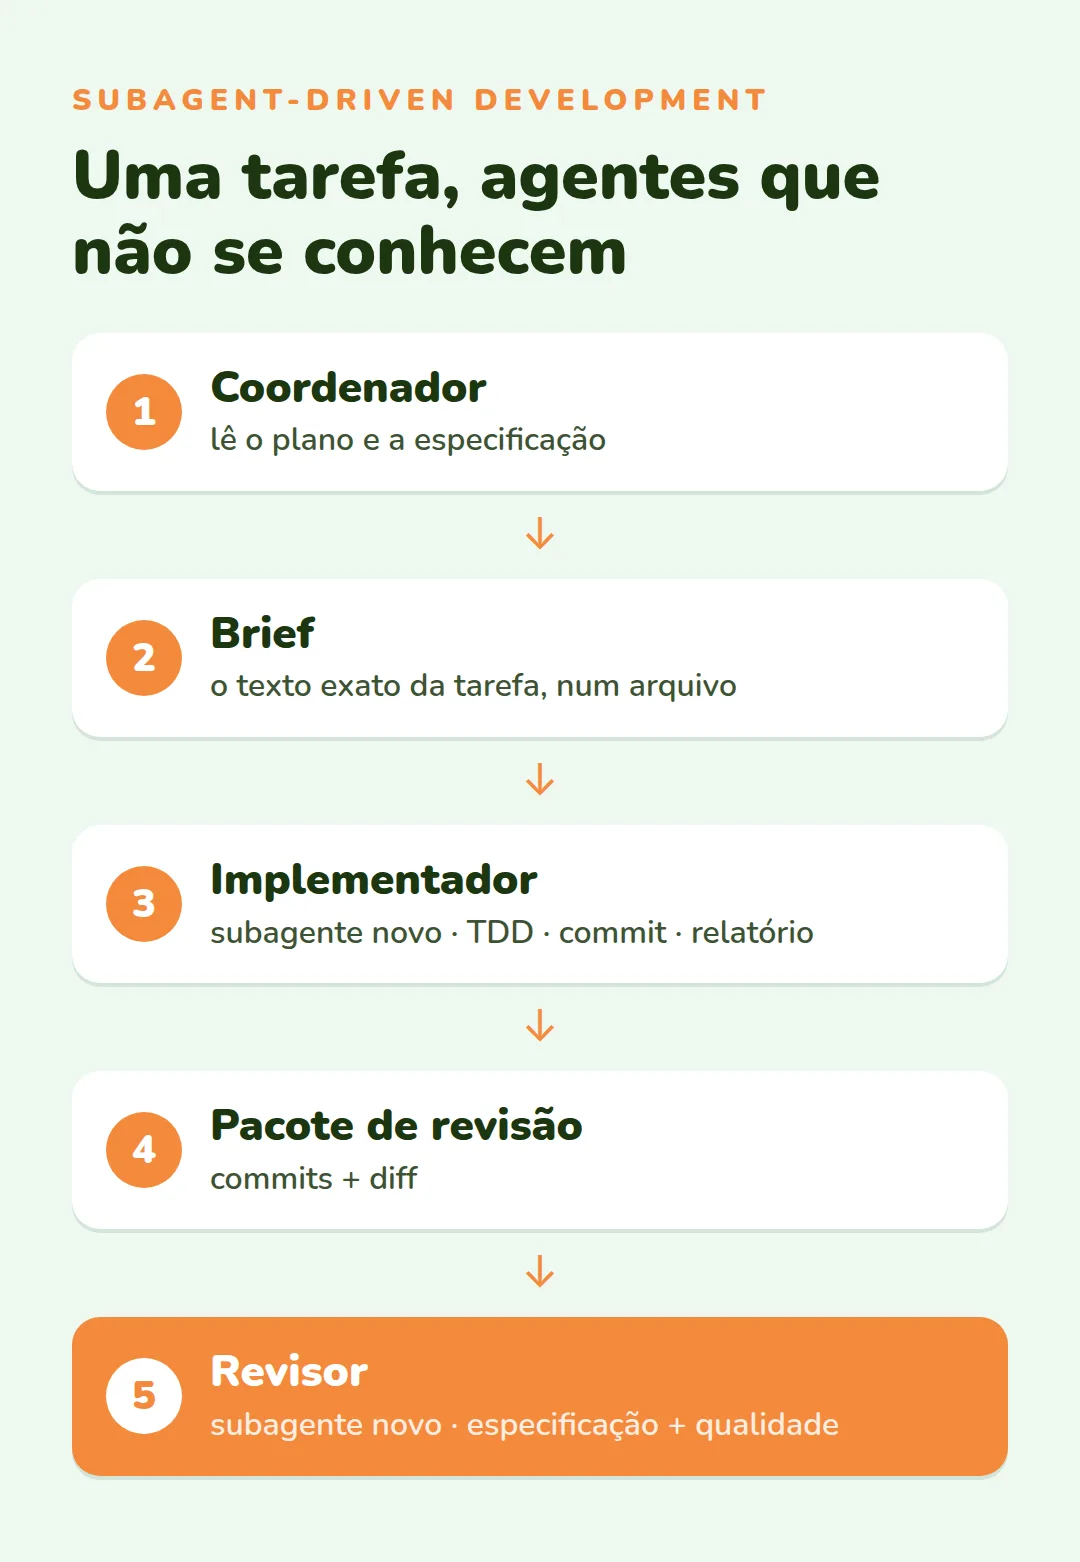
O implementador pode perguntar antes de começar, faz o TDD, comita, se revisa e escreve um relatório num arquivo, devolvendo um status: pronto, pronto com ressalvas, precisa de contexto ou bloqueado. Aí entra outro subagente novo, o revisor, que recebe os commits e o diff e confere duas coisas: se o código faz o que a especificação pede e se tem qualidade.
Tem também um ledger, um arquivo de progresso que sobrevive quando o contexto do coordenador é compactado. Parece detalhe, mas está documentado que a falha mais cara observada era um coordenador que perdia o fio e mandava refazer sequências inteiras de tarefas já prontas. E a escolha de modelo é por complexidade: tarefa mecânica vai pra um modelo rápido e barato, integração pro padrão, e arquitetura e revisão final pro mais capaz.
O laço de correção
Se o revisor acha um problema crítico ou importante, entra o laço de correção, com até cinco rodadas.
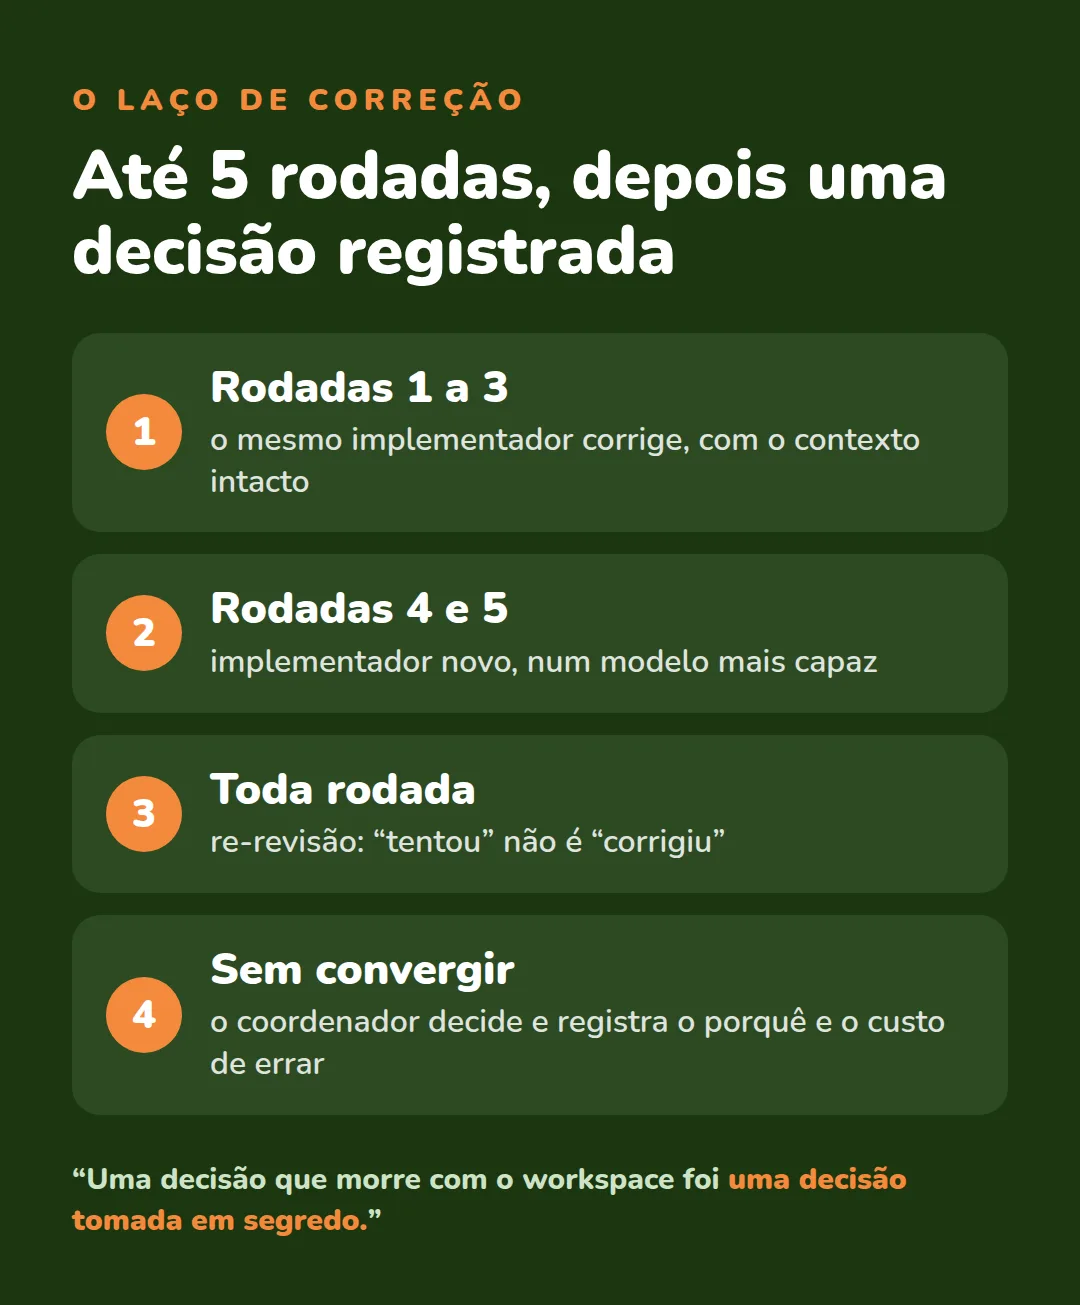
Nas três primeiras, o mesmo implementador corrige, com o contexto intacto. Nas rodadas quatro e cinco, entra um implementador novo, num modelo mais capaz, porque às vezes o agente simplesmente não enxerga o próprio erro. Toda rodada termina com uma nova revisão focada na correção, e cada achado é marcado como resolvido ou não. "Tentei" não é "corrigi". Se na quinta rodada ainda não convergiu, o coordenador decide e registra a decisão, o porquê e o custo de estar errado. A frase da skill que eu mais gosto é: "Uma decisão que morre com o workspace foi uma decisão tomada em segredo."
Como a revisão barra alucinações
E aqui está, a meu ver, o coração do processo. A instrução que o revisor recebe é literalmente: "Não confie no relatório."
Tudo o que o implementador diz é uma afirmação não verificada até bater com o diff. Até justificativas como "deixei assim por YAGNI" são tratadas como afirmação e não servem pra rebaixar a gravidade de um problema. O revisor é um subagente novo, sem o histórico da sessão, então não tem o viés de quem fez. Ele procura o que está faltando, o que é extra (aquilo que ninguém pediu) e o que foi mal-entendido (a funcionalidade certa do jeito errado). O que não dá pra verificar pelo diff vira um item marcado, pra não ser inventado. E o coordenador é proibido de "aliviar" o revisor com instruções como "não aponte isso".
Quem leu o meu post sobre taxas de alucinação entende por que eu gosto tanto disso. O modelo erra, e vai continuar errando; a diferença é que aqui o erro de um agente precisa passar por outro agente desconfiado e por evidência concreta (arquivo e linha, saída de teste) antes de chegar ao jogo.
A nossa adaptação: um worktree por agente
A skill original diz para nunca despachar vários implementadores em paralelo, porque eles brigariam pelo mesmo diretório. No projeto, a gente resolveu isso dando a cada implementador paralelo o seu próprio git worktree e branch. Depois que a revisão sai limpa, os commits são trazidos pra branch da funcionalidade, e os revisores olham sempre uma faixa de commits, nunca a pasta de trabalho, que pode estar sendo mexida por outro agente.
E depois de cada implementador, independentemente do que ele disse, roda uma verificação obrigatória: análise estática do projeto inteiro, conferência dos arquivos alterados e do que ficou sem rastrear. Essa regra tem justificativa escrita: um import não usado ficou esquecido num arquivo por vários commits, e duas variáveis mortas passaram por uma checagem feita arquivo por arquivo. Implementador dizer "pronto" não significa que está pronto.
A rede de segurança
Por fim, por baixo de tudo isso, tem a pirâmide de testes: cerca de 1.500 testes unitários e de widget, mais de 95 cenários de ponta a ponta que rodam sem aparelho em menos de um minuto, testes de imagem de referência (5 telas em 3 tamanhos) e até um APK de teste que roda os cenários no próprio celular e exporta um relatório.
E a cada push, o GitHub Actions roda a análise estática, os testes e barra tudo se a cobertura ficar abaixo de 70%. Foram 1.681 commits em seis meses, e isso só é sustentável porque existe essa rede. Testes não deixam o projeto lento, eles são o que permite ir rápido sem quebrar o que já funcionava.
No próximo post, eu falo das regras da casa: os arquivos CLAUDE.md, que são a memória do projeto, e uma skill chamada Ponytail, que se descreve como um "sênior preguiçoso".